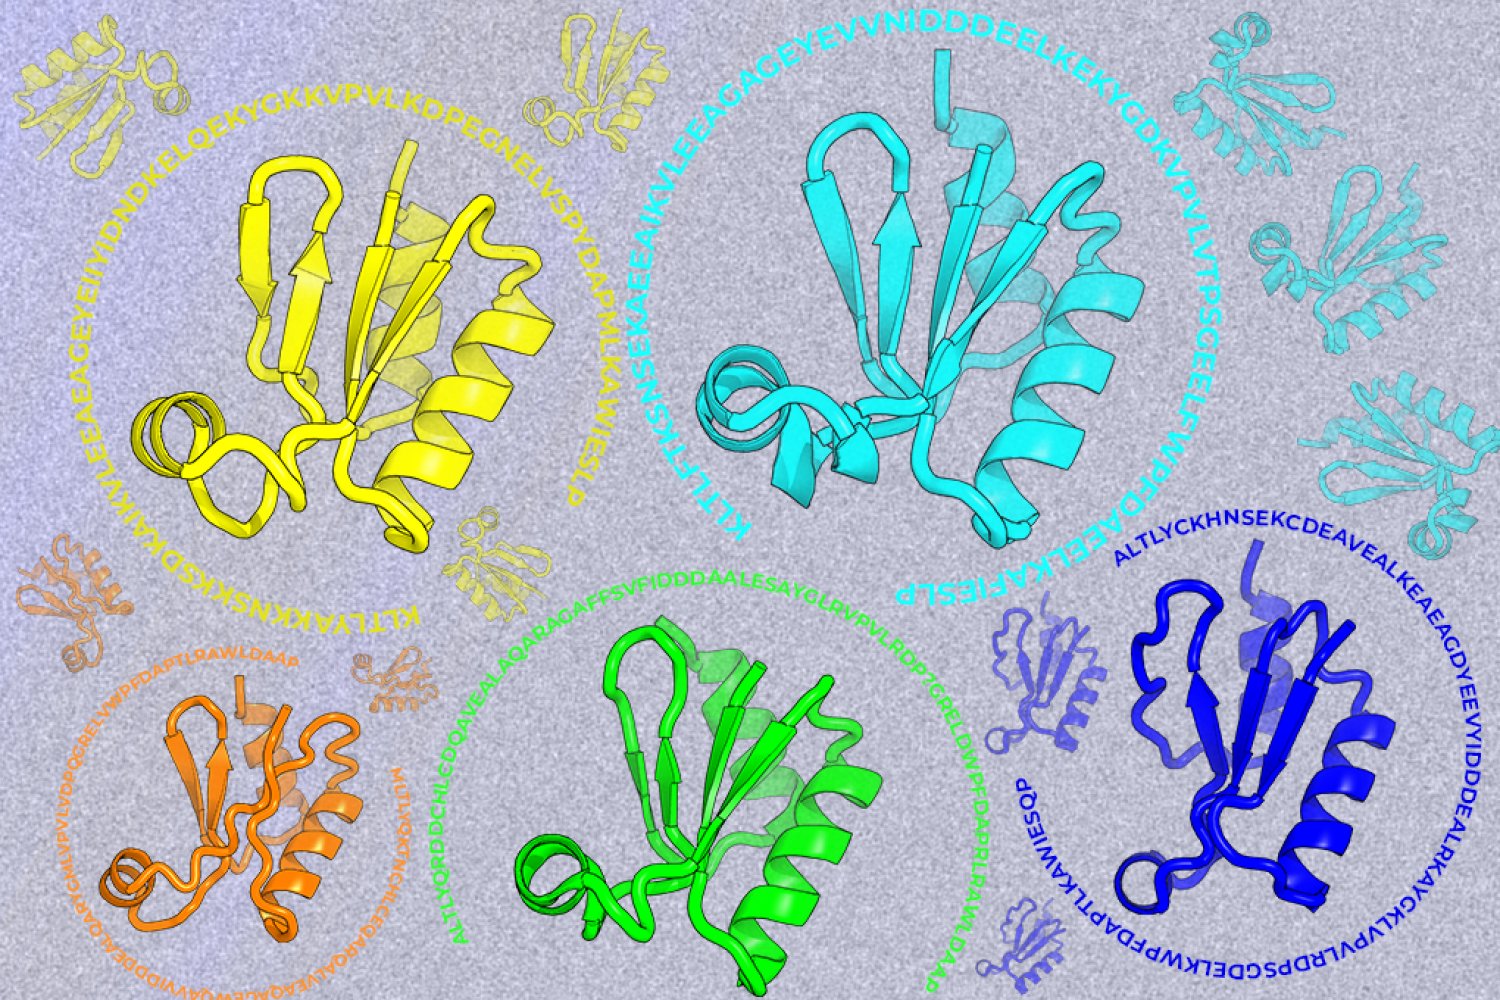
蛋白質的功能由其結構決定,而結構(即蛋白質的摺疊方式)則由其胺基酸序列(蛋白質的基本組成單元)所決定。許多設計新型蛋白質的方法,包括那些能與細胞中致病分子結合的蛋白質,都涉及兩步驟過程:首先確定結構,然後由機器學習框架生成一系列可能採用該結構的序列。
在自然界中,許多不同的胺基酸序列可以摺疊成相同的結構。同時,一個胺基酸序列也可能根據蛋白質的柔韌性或功能觸發條件,採用不同的結構。因此,當研究人員利用人工智慧設計新蛋白質時,挑戰在於引導 AI「看見」許多潛在有用的答案,即許多序列都能採用相同的摺疊方式。
「多年來,這個領域一直以模型能否重現演化所選擇的蛋白質序列來衡量成功,但我們的研究顯示,這並非蛋白質設計的最佳指標。」生物學系主任、Jay A. Stein (1968) 生物學教授兼生物工程學教授,以及近期發表於 PNAS 論文的資深作者 Amy E. Keating 表示。
由生物學系開發的新型機器學習框架 PottsMPNN,整合了控制蛋白質結構和穩定性的物理原理。這不僅改進了序列生成,也提升了預測突變如何影響蛋白質穩定性的能力。換句話說,該模型對「序列-能量圖景」(sequence-energy landscape)有了更深入的理解,即每個胺基酸的特性與蛋白質穩定性之間的關係。
將此框架整合到蛋白質設計流程中,將使研究人員能夠設計出結構可行,且序列與任何天然蛋白質都不相似的蛋白質。主要作者兼研究生 Foster Birnbaum 指出:「如果我們考慮的是一個全新的設計結構,那麼就沒有天然序列可以與之比較。」
他進一步說明:「我們真正關心的是,生成的序列有多大可能摺疊成所需的結構,模型對序列-能量圖景的理解程度,以及它預測突變對蛋白質穩定性影響的能力。」
如同人工智慧近年來推動了一些劇烈的社會變革,機器學習也同樣影響了基礎生物學研究的速度和廣度。直到最近,才有可能可靠地使用計算模型來生成蛋白質結構或序列。然而,目前最廣泛使用的模型是在 2022 年發布的。
Birnbaum 表示:「對於生物學機器學習這樣快速發展的領域來說,那個模型至今尚未被超越。我們一直在努力理解這是為什麼,以及那個模型究竟有何獨特之處,使其如此有用。」
Birnbaum 最初對研究人員稱之為「雜訊」(noise)的策略應用感興趣,即在訓練過程中為蛋白質結構添加變異。雜訊能降低模型過度模仿天然序列的傾向,從而增加其能生成序列的結構多樣性。
PottsMPNN 還利用成對分佈(pairwise distribution)來捕捉胺基酸之間的相互作用。它能夠考慮蛋白質中一對位置上所有 20 種可能序列選項之間的物理相互作用,這是 PottsMPNN 比其他方法更準確地建模序列-能量圖景的關鍵原因。Birnbaum 最後提到,他們還將一系列演化相關序列引入 PottsMPNN 框架的訓練中,以教導模型不同的序列如何能採用相同的摺疊結構。
Birnbaum 承認,儘管試圖擺脫對天然序列的依賴,但納入演化資訊在某些方面仍然是一種依賴。然而,PottsMPNN 成功證明,隨著模型對天然序列的依賴程度降低,其結構相容性和能量預測能力(包括對新型蛋白質的預測)都會有所提升。
談到 AI 時代的蛋白質設計,Birnbaum 表示:「一旦我們能設計出任何我們想要的蛋白質,這將使我們能夠進行潛在規模龐大的生物工程。這是一項艱鉅的任務,但我對本世紀生物學的進步感到非常樂觀。」
Birnbaum 希望該模型能進一步改進並針對特定任務進行微調,這在過去曾帶來更好的預測,例如關於特定突變的結果或影響。Keating 最後總結:「我們的方法正推動該領域朝著為多樣化應用設計有用且『自然界中不存在』的新型蛋白質邁進,同時也為未來的進步奠定了更堅實的基礎。」