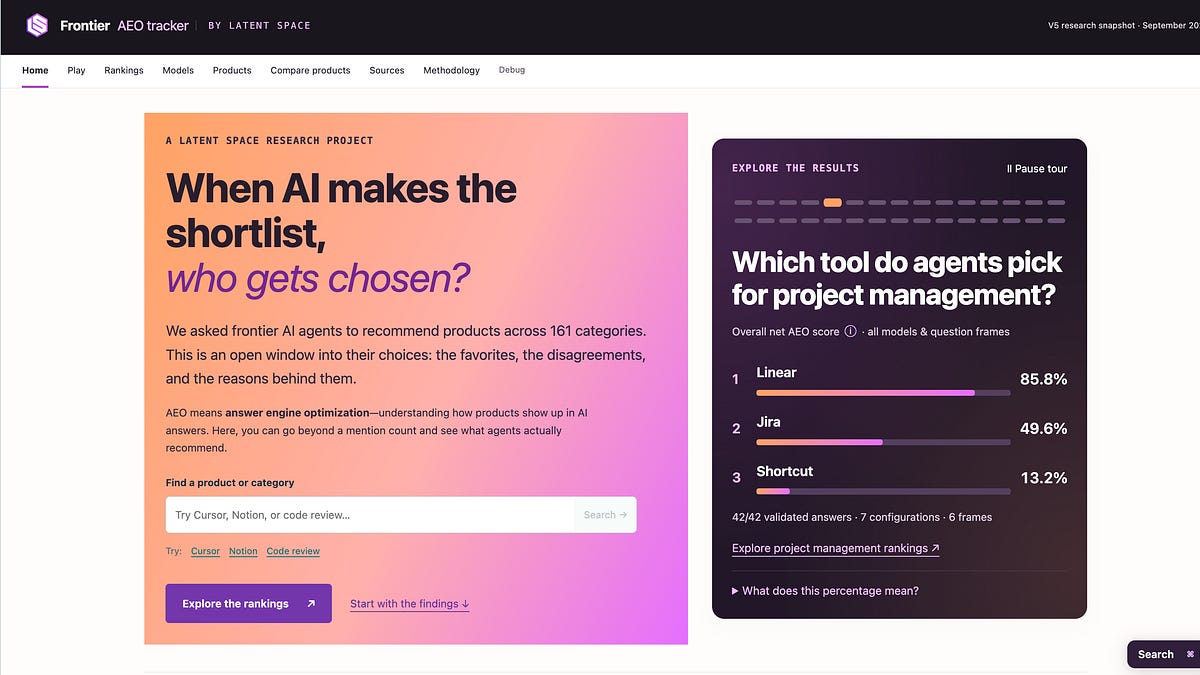
我們對 AEO(Agentic Execution Optimization)的初步自動研究投資已帶來可觀的投資報酬率,因此自然而然地,我們決定認真對待它。受到「Claude Code 實際選擇了什麼」的啟發,我們決定擴展並調整其方法以符合我們的需求。
經過數十億個 token 的原型設計、對齊和擴展管道後,Latent Space 前沿 AEO 追蹤器正式推出。我們的方法擴展了 AmplifyingAI 的技術,對七個模型進行六種提示變體測試,涵蓋 161 個類別,從程式碼代理到 AI 播客、AI 沙盒、託管資料庫、ASR 模型,甚至包括天使投資人和企業支出、薪資軟體等特殊類別。
答案提取由 Astra 完成,並根據專有的 AEO 分數進行評分。此分數會權衡首選、替代選擇、提及,同時對輕微和強烈的負面推薦(雖然罕見但確實發生)給予負權重。因為我們知道您會想知道,我們也提取了影響代理推薦的頂級引用來源,並分析了主要的失敗案例。
以下是全球各類別中最具主導地位的產品。其中有一些熟悉的名字,這自然引發了污染問題,我們也已進行了檢查。由於我們沒有什麼可隱瞞的,每個提示和答案對都可以被檢視。
然而,偏見確實存在。當模型被要求提供程式碼代理推薦時,Fable/Opus 喜歡 Claude Code,Sol/Astra 喜歡 Codex,Grok 喜歡 Cursor,Muse 喜歡 Muse Code,SWE-1.7 喜歡 Devin,諸如此類。我不禁好奇原因。您也可以看到其他「軟性偏見」的出現。
儘管如此,也有值得注意的 GPT 模型推薦 Claude 的例子,這是一種值得稱讚的非偏見行為。在我們總共 161 個類別中,有 28 個類別在所有受調查的前沿模型中都存在一個普遍佔主導地位的首選。
還有更多「勢均力敵的競爭」和「總是伴娘,從未是新娘」的類別,這些應該是 AEO 的關鍵戰場。針對新模型類別的新預訓練,代表著一個新的機會,可以檢視實驗室在資料和強化學習優先事項上的動向,並檢查新創公司在 AEO 上的投資是否有所回報。
我們準備了特別報告,分析我們的排名,觀察到同一實驗室不同模型世代之間,模型選擇發生了非常重大的轉變。我們有獨立的 Opus→Fable 和 Sol→Astra 摘要頁面。對於某些轉變,我們突出了對競爭對手在每種情況下表現更好的中立分析。
在 Sol→Astra 和 Opus→Fable 之間的發現中,最令人驚訝的是 Anthropic 似乎偏向讓其模型搜尋更多來源(Sol 中位數為 9 個來源,Astra 中位數為 5 個來源,而 Opus 中位數為 11 個來源,Fable 為 15 個來源)。
Astra 似乎普遍更「自信」或「高效」,這取決於您如何看待它。當您輕微改寫問題時,Astra 改變主意的可能性要小得多。這使得當選擇隨機性下降時,AEO 本身的價值隨之上升。
來源分析在某種程度上也強烈預測了實驗室優先考慮和不優先考慮的事項。然而,這裡的樣本量很小,僅代表我們從嘗試的工具呼叫中抓取的內容,而非預訓練資料集。我們可以驗證的是,Ora 和 Vercel 衡量的 AEO 實踐,例如 Markdown 內容協商,是真實存在的,並且失敗會阻止模型閱讀您的內容。
以下是根據大型語言模型評選出的全球頂級天使投資人(部分重複項目待處理)。我們還製作了一個類似「家庭糾紛」的小遊戲,您可以看看您的先驗知識是否與數據一致。很有趣!
如果您感興趣,我們歡迎進一步的建議和業務諮詢,以開發此項目。請聯繫 @latentspacepod 或發送電子郵件至 [email protected](我們現在有業務經理了!太棒了!)。正如我們在方法論文章中提到的,我們非常努力地嘗試納入 Gemini/Antigravity、GLM/Zcode 和 DeepSeek/DeepCode,但錯誤和速率限制使得它們無法納入本次首次運行分析。如果您代表這些公司,請告知我們如何提高限制。