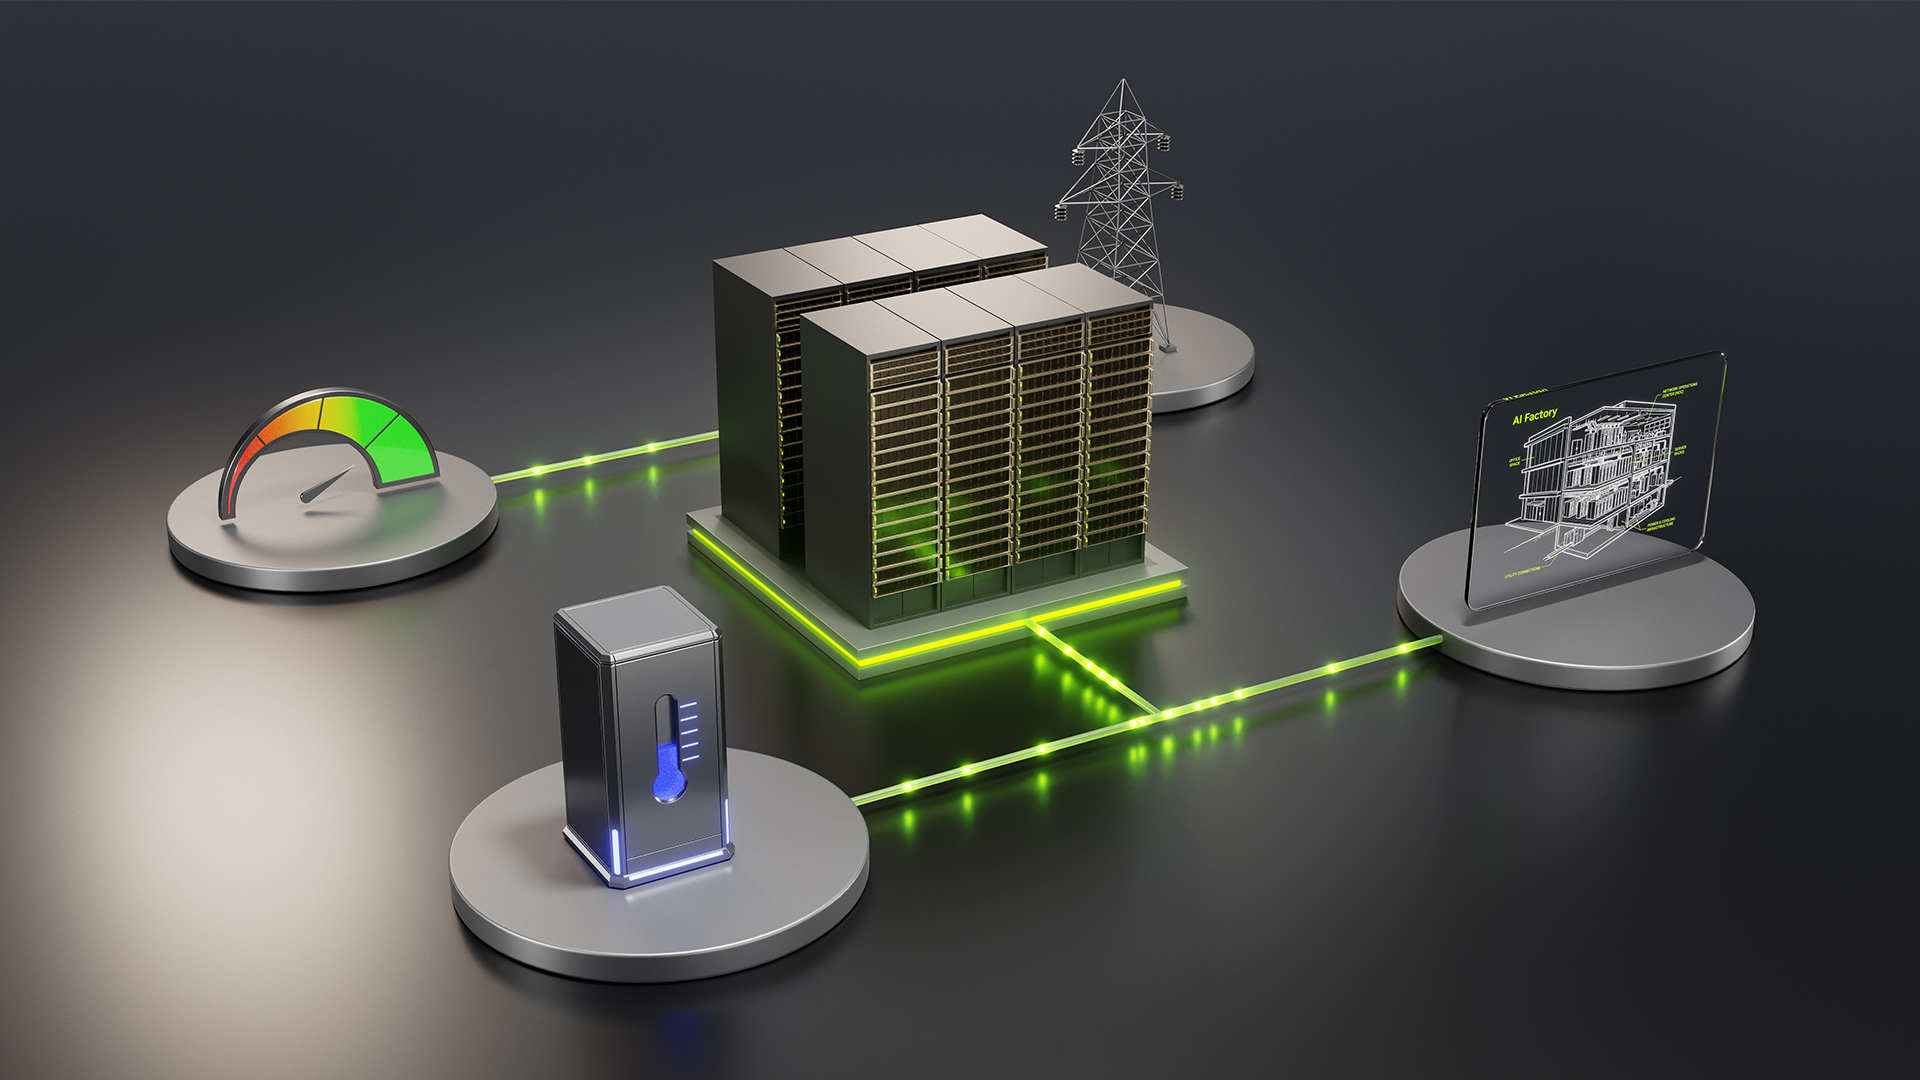
在矽谷一個炎熱的八月夜晚,隨著夕陽西下,空調負載飆升,Silicon Valley Power 向一座 AI 工廠發出訊號,要求其調整用電量。
Varun Sivaram 和大約四十人透過 Zoom 觀看,包括他在 Emerald AI 舊金山會議室的團隊、資料中心的工程師以及電力公司的人員。沒有人動手操作任何東西。
NVIDIA 合作夥伴 Emerald AI 的 Conductor 平台是一個電網協調平台,也是 NVIDIA DSX Flex 旨在提供彈性的一個早期範例。它接收電網狀況的訊號,並調整資料中心的彈性運算工作負載。可以等待的工作會被減速或重新排程,而優先級較高的服務則繼續運行。
目標是在電網受限時減少電力需求,同時不中斷關鍵的 AI 工作負載——這正是 Silicon Valley Power 所需要的。當螢幕上顯示出電力減少時,所有人都歡呼起來。
Sivaram 表示:「我們屏息以待。這是我們首次在數千個 NVIDIA GPU 上部署。」他的產品主管 Mansi Shah 激動地說:「這感覺有點像 SpaceX 火箭發射。」
此後,Silicon Valley Power 已向該 AI 工廠發送了 200 多個需求訊號,每次都成功運作。
Emerald AI 舊金山團隊觀察到 Silicon Valley Power 的需求訊號傳達到工廠,電力自動從四兆瓦降至三兆瓦,同時所有高優先級任務持續運行。
這就是生產中的電網彈性。它指向的意義遠不止聖塔克拉拉的一座設施:這是一條為美國 AI 工廠解鎖所需電力的方法,無需等待十年來建設新的輸電線路。
在週二的 AI Infra Summit 上,NVIDIA 超大規模和高效能運算副總裁 Ian Buck 將 AI 工廠效率作為其基礎設施主題演講的核心。
雲端服務供應商 Lambda 同日發布了其在部署環境中首次驗證的結果,數據顯示:在智慧管理下,固定的電力預算可以支援多達 24% 的 Token 吞吐量。
Lambda 雲端服務總裁 Dave Ward 表示:「透過我們的概念驗證,我們相信我們已經超越了固定電力預算的限制。NVIDIA DSX MaxLPS 為回收閒置容量並將其轉化為實際使用鋪平了道路,在相同的佔用空間內實現了顯著更高的運算密度。」
在那個八月夜晚,當 SVP 發出訊號時,Conductor 根據預定義的工作負載層級執行:最低優先級的任務讓步,高優先級的推論任務持續運行,電力從四兆瓦降至三兆瓦。整個過程自動化,無需操作員介入。
在 AI 工廠經濟中,電力是主要的限制。每吉瓦的工作量是衡量標準。資料中心營運商對效率非常講究——每一瓦特的電力都用於提供生產性運算,業界在堆疊的每一層都取得了顯著的進展,從設施設計到機架級電力轉換。
DSX 將這種嚴謹性延伸到 AI 工作負載本身。更智慧的機架配置將電力分配到工作負載實際需要的地方。營運智慧——更緊密的排程、更快的重啟、更精簡的檢查點——讓 GPU 持續運行而不是等待。目標與營運商一直追求的相同:從現有電力中獲得更多工作量。
NVIDIA 創辦人暨執行長黃仁勳曾表示:「一個一吉瓦的工廠永遠不會變成一個兩吉瓦的工廠。」
當系統達到物理極限時,工程師們得出的答案總是一樣的:停止優化單一組件,開始設計整體。
NVIDIA DSX 是今年五月在 GTC 台北發表,正是 AI 工廠的解決方案——而早期的部署已經證明了它的有效性。
這個完整平台涵蓋網路、散熱、水效率和設施設計;以下章節將重點介紹目前在電力管理和電網參與方面的一些成果。
**相同預算,更多運算:DSX MaxLPS**
Lambda 在 AI Infra Summit 上發布的結果,是 DSX MaxLPS 在 NVIDIA HGX B200 GPU 伺服器上首次獲得驗證。
DSX MaxLPS 監控 GPU 和機架級功耗,並根據工作負載類型在節點之間重新分配餘裕,從而回收靜態配置會閒置的容量。訓練和推論的功耗不同;MaxLPS 優化了同時運行這兩者的 AI 工廠的電力分配。
Lambda 是一家 GPU 雲端服務供應商,為從 AI 原生新創公司到超大規模企業的 10,000 多名客戶提供服務,他們在一個五機架、19 節點的叢集上運行了該軟體。
他們發現:透過在與 16 個節點全功率運行相同的電力預算下運行 19 個節點,Lambda 實現了叢集範圍內 24% 的 Token 吞吐量提升——從每秒約 400 萬個 Token 增加到 500 萬個。每瓦效能提升了 23%。
根據 NVIDIA 的預測,DSX MaxLPS 可以在合適的部署環境中,在相同的兆瓦電力預算下,為下一代 Vera Rubin NVL72 AI 工廠提供高達 40% 的 GPU 容量。
**自動化需求響應,生產中驗證**
聖塔克拉拉的故事並非 DSX Flex 的安裝案例——它更早且更重要:證明了這個概念在商業規模上是可行的。
NVIDIA 的 Eos AI 工廠正在運行 Emerald AI Conductor,作為 Silicon Valley Power 彈性負載互連計畫的參與者,這是第一個將 AI 工廠視為可調度資源的商業電網公用事業計畫。
當 Silicon Valley Power 發出訊號時,Conductor 會在一分鐘內響應。願意彈性調整的工廠可以運行更大的規模。
這正是 DSX Flex 旨在推廣的模式——隨著平台成熟,Emerald AI Conductor 將整合到 DSX Flex 中。第一個專用的 DSX Flex 商業部署將是維吉尼亞州馬納薩斯(Manassas)的設施:NVIDIA AI 工廠研究中心的一個 96 兆瓦 Vera Rubin AI 工廠,該計畫建立在橫跨兩大洲的五個先前示範基礎之上。
**下一代電力架構層:800V 直流電源架構**
當今 AI 工廠內部的效益是真實且現在即可部署的。下一層是如何將電力傳輸到更密集的加速運算機架。
隨著 AI 工廠規模擴大,傳統的低電壓供電路徑增加了轉換複雜性和配電限制。
NVIDIA 的 800 VDC 架構旨在減少轉換複雜性、提高電力傳輸效率並支援更密集的加速運算機架。
NVIDIA DSX 正在將 800V 直流電納入其參考設計中。
**最佳化整座工廠,而非單一組件**
沒有單一組件可以獨立優化 AI 工廠。更快的 GPU 仍然會受限於網路。不當的配置可能導致電力閒置。散熱開銷仍然會將電力從 GPU 轉移;運行直接液冷系統的 GB200 NVL72 機架會產生約 120 kW 的熱量,這些熱量在電力到達運算單元之前必須被排出。
實現每兆瓦更多 Token 的唯一可靠途徑是優化整座工廠——在第一個機架安裝前使用 DSX Sim,運行後使用 DSX OS 和 DSX Exchange,以及 DSX 參考設計,讓建置者從經過驗證的架構開始,而不是從頭做起。(請參閱側邊欄,快速了解完整的 DSX 套件。)
**吉瓦級基礎設施標準**
歸根結底只有一個問題:工廠每消耗一兆瓦電力,能產生多少有用的工作量?
NVIDIA DSX 為基礎設施建置者提供了參考設計、模擬工具、營運軟體和電力管理技術,使其能夠在當前硬體和下一代產品上,以此指標進行競爭。
當電網需要緩解時,工廠在不中斷任何任務、不要求更多電力的情況下提供了支援。
透過 NVIDIA DSX,這成為了 AI 工廠應有表現的新基準。